Case Study
Enterprise Data Lake
& ETL Platform
Building reliable data pipeline for scalable analytics
01 / Overview
Project Overview
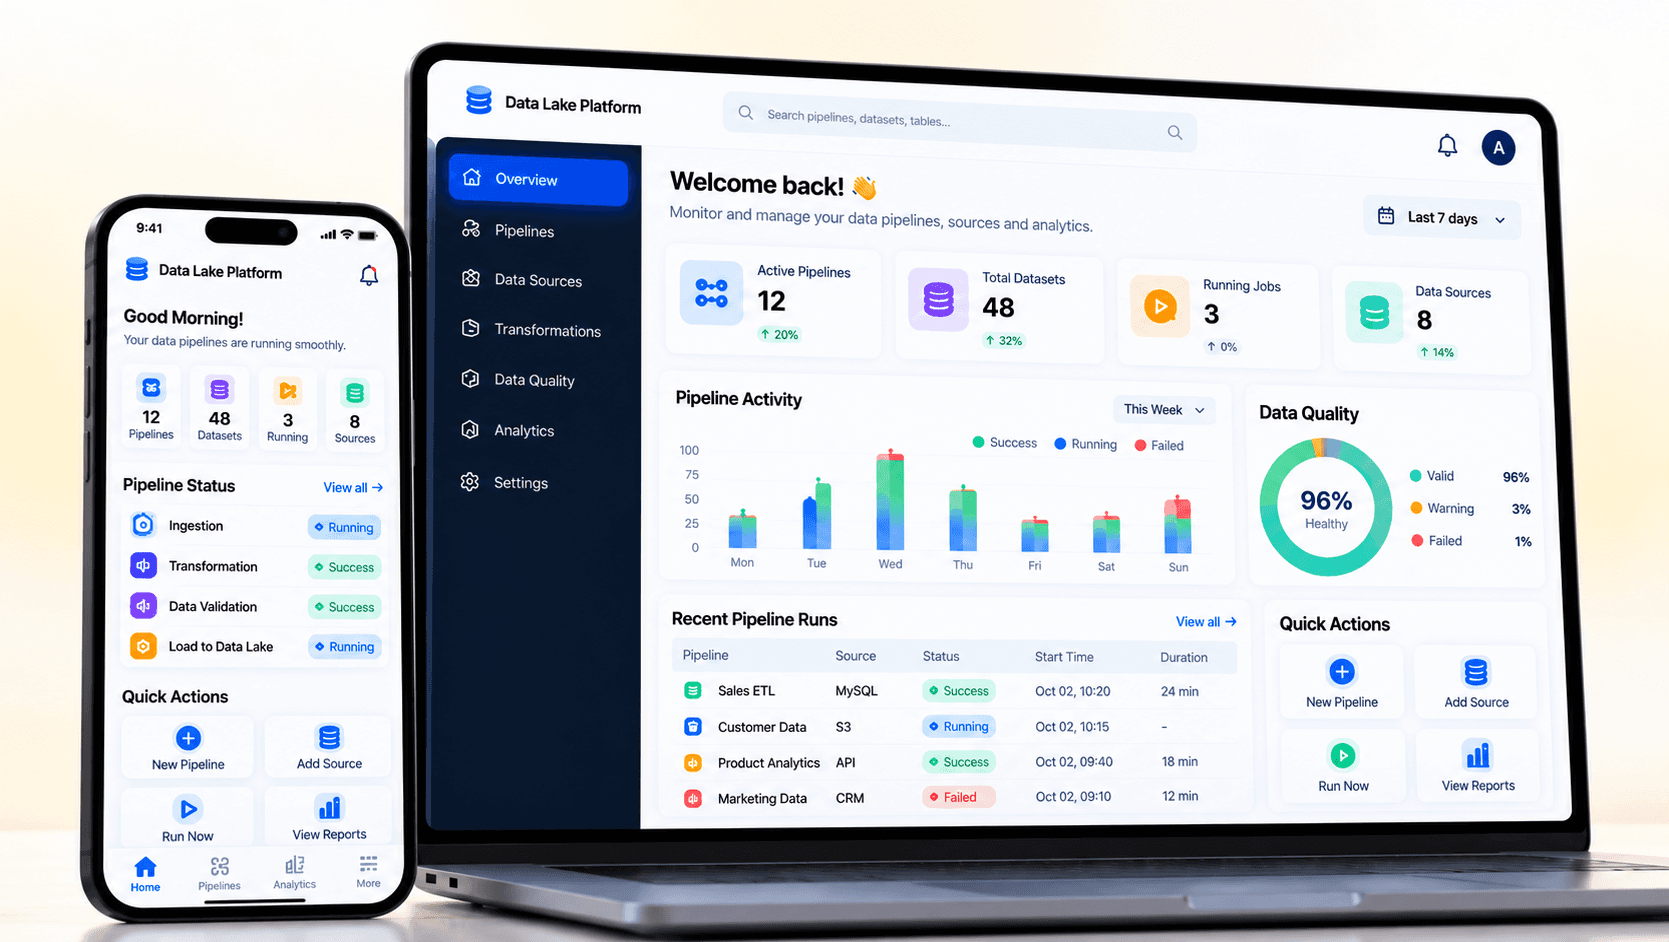
A scalable data engineering platform designed to collect, transform, validate, store, and prepare data from multiple sources for analytics.
Role
Data Engineering
Duration
Project-based
Industry
Data & Analytics
Services
ETL/ELT, Data Pipeline, Data Processing
02 / Challenge
The Challenge
Organizations had data spread across multiple systems, with inconsistent data formats and quality issues, leading to manual processing, delayed insights, and inefficient analytics.
Fragmented Data Sources
Multiple Tools with no integration.
Inconsistent Data Quality
Missing values, duplicate records and different formats
Manual Processing
Time-consuming manual data extraction and transformation.
03 / Solution
The Solutions
We built a centralized data engineering platform with automated pipelines for data ingestion, orchestration, transformation, validation, and analytics-ready storage using a modern data lake architecture.
Data Sources
Databases APIs | Files Third-party tools
Apache Airflow
Pipeline Orchestration Scheduling
PySpark
Data Transformation Processing
Data Validation
Quality Checks Schema Validation Error Handling
Delta Lake
Scalable Storage Governed Data ACID Transactions
Analytics
BI Tools Reports Dashboards
04 / Technology
Technology Used
Apache Airflow
Pipeline orchestration
SQL
Data Querying & Transformations
Data Warehouse
Analytics & Reporting
Python
Scripting & Processing
PySpark
Distributed Data Processing
Delta Lake
Data Lake Storage
05 / Impact
Business Impact
Centralized Data
Unified Data for multiple Sources.
Automated Pipelines
Reliable and scheduled data processing
Better Data Quality
Validation and consistent data for analytics
Scalable Foundation
Clean and structured datasets for BI and reporting